AI 코딩 지시 잘하는 법: 실제 대화 로그로 본 말버릇 6가지
사람이 직접 검수한 글 · 검수 검수 방식
AI 코딩 도구에 다시 시킬 때 결과가 바로 바뀐 말에는 기준이 하나씩 붙어 있었습니다(숫자, 읽는 사람, 참고할 예, 그림). 제가 Claude Code로 진행한 프로젝트 3개의 대화 기록에서 그런 말 6가지를 골랐습니다. 문구는 3분 5초, 손그림으로 그린 화면은 11분 42초 만에 실제 사이트에 올라갔습니다.
직접 해 본 결과
- 문구 고치기 "일반인 관점으로" 요청 → 수정·배포
- 3분 5초
- 홍보 글 다듬기 3분 9초, 사람이 보낸 메시지 3개
- 357→237자
- 손그림 → 배포 그림 1장 + 지적 1번
- 11분 42초
이 글의 파일
이 글은 작업 중간에 고쳐 말하는 법입니다. 시작하기 전에 주는 문서는 시리즈 1편: 바이브코딩 첫 지시는 문서 한 장에서 다뤘습니다.
이런 분께 / 준비물
이런 분께 맞습니다.
- AI로 만든 페이지·글·화면이 어딘가 마음에 안 드는데 뭐라고 고쳐 달라고 할지 막히는 분
- “더 예쁘게”, “더 쉽게”를 보냈는데 비슷한 결과만 다시 받은 분
준비물
- AI 코딩 도구 하나. 이 글의 기록은 Claude Code 기준입니다.
- 말버릇 6가지 빈칸 템플릿(텍스트 파일, 메모장으로 열림)
6가지 한눈에 보기
모두 실제로 보낸 말이고, 걸린 시간은 대화 기록의 메시지 시각으로 쟀습니다.
| 말버릇 | 실제로 보낸 말 (요지) | AI가 한 일 | 걸린 시간 | 바뀐 것 |
|---|---|---|---|---|
| 1. 숫자 기준으로 | "가독성 점수로 검토 후 수정" | 지표 목표를 먼저 정하고 3개 페이지를 고친 뒤 다시 측정 | 18분 51초 (배포까지) | 전체 글자 수 3,613 → 1,016 (AI 측정) |
| 2. 시안 3개 | "각기 다른 스타일 3개 정도 만들어 봐" | 같은 내용, 다른 디자인 3개 + 비교 화면 | 6분 18초 + 고른 뒤 7분 18초 | 한 글자 "B"로 페이지 4개 적용 |
| 3. 예 하나 + 이유 | "사용자는 디자인만 봐도 수준을 판단… (토스 스타일)" | 화면 전체 리디자인 후 브라우저로 직접 확인 | 23분 19초 | 같은 세션에서 디자인 재요청 없음 |
| 4. 읽는 사람 | "사용자 관점에서 이해 쉽도록(일반인) 수정" | 버전 이름과 설명 바꿔 배포 | 3분 5초 | "v1 · Refined / v2 · Showcase" → "차분한 고급형 / 화려한 연출형" |
| 5. 예시일 뿐 + 어색한 줄 | "예시일 뿐이고 다시 작성해" + 어색한 줄 붙여 넣기 | 새로 쓰고, 짚은 줄만 삭제 | 3분 9초 | 357자 → 237자 |
| 6. 그려서 보내기 | "대충 발로 그렸는데…" + 손그림 1장 | 그림을 해석해 구현, 지적 1번 뒤 수정 | 11분 42초 (배포까지) | 카드 6장 부채꼴 → 한 장씩 크게 넘기기 |
1. “별로야” 대신 숫자 기준으로 말하기
느낌만 있을 때는 그 느낌을 잴 기준까지 같이 말합니다. “글이 너무 많아 보인다”에 “한 화면에 읽을 수 있는 정도”라는 기준을 붙였더니, AI가 측정 항목과 목표치부터 정했습니다.
- AI가 정한 목표: 전체 글자 수 1,800자 이하, 휴대폰 첫 화면 130자 이하, 평균 문장 25자 이하 등
- 결과(AI가 측정 스크립트로 잰 값, 휴대폰 375px 기준):
| 지표 | 페이지 A | 페이지 B | 페이지 C |
|---|---|---|---|
| 전체 글자 수 | 3,613 → 1,016 | 3,790 → 1,023 | 3,227 → 1,233 |
| 첫 화면 글자 수 | 278 → 111 | 288 → 116 | 300 → 126 |
| 페이지 길이(화면 수) | 10.9 → 6.9 | 11.5 → 6.8 | 8.5 → 6.5 |
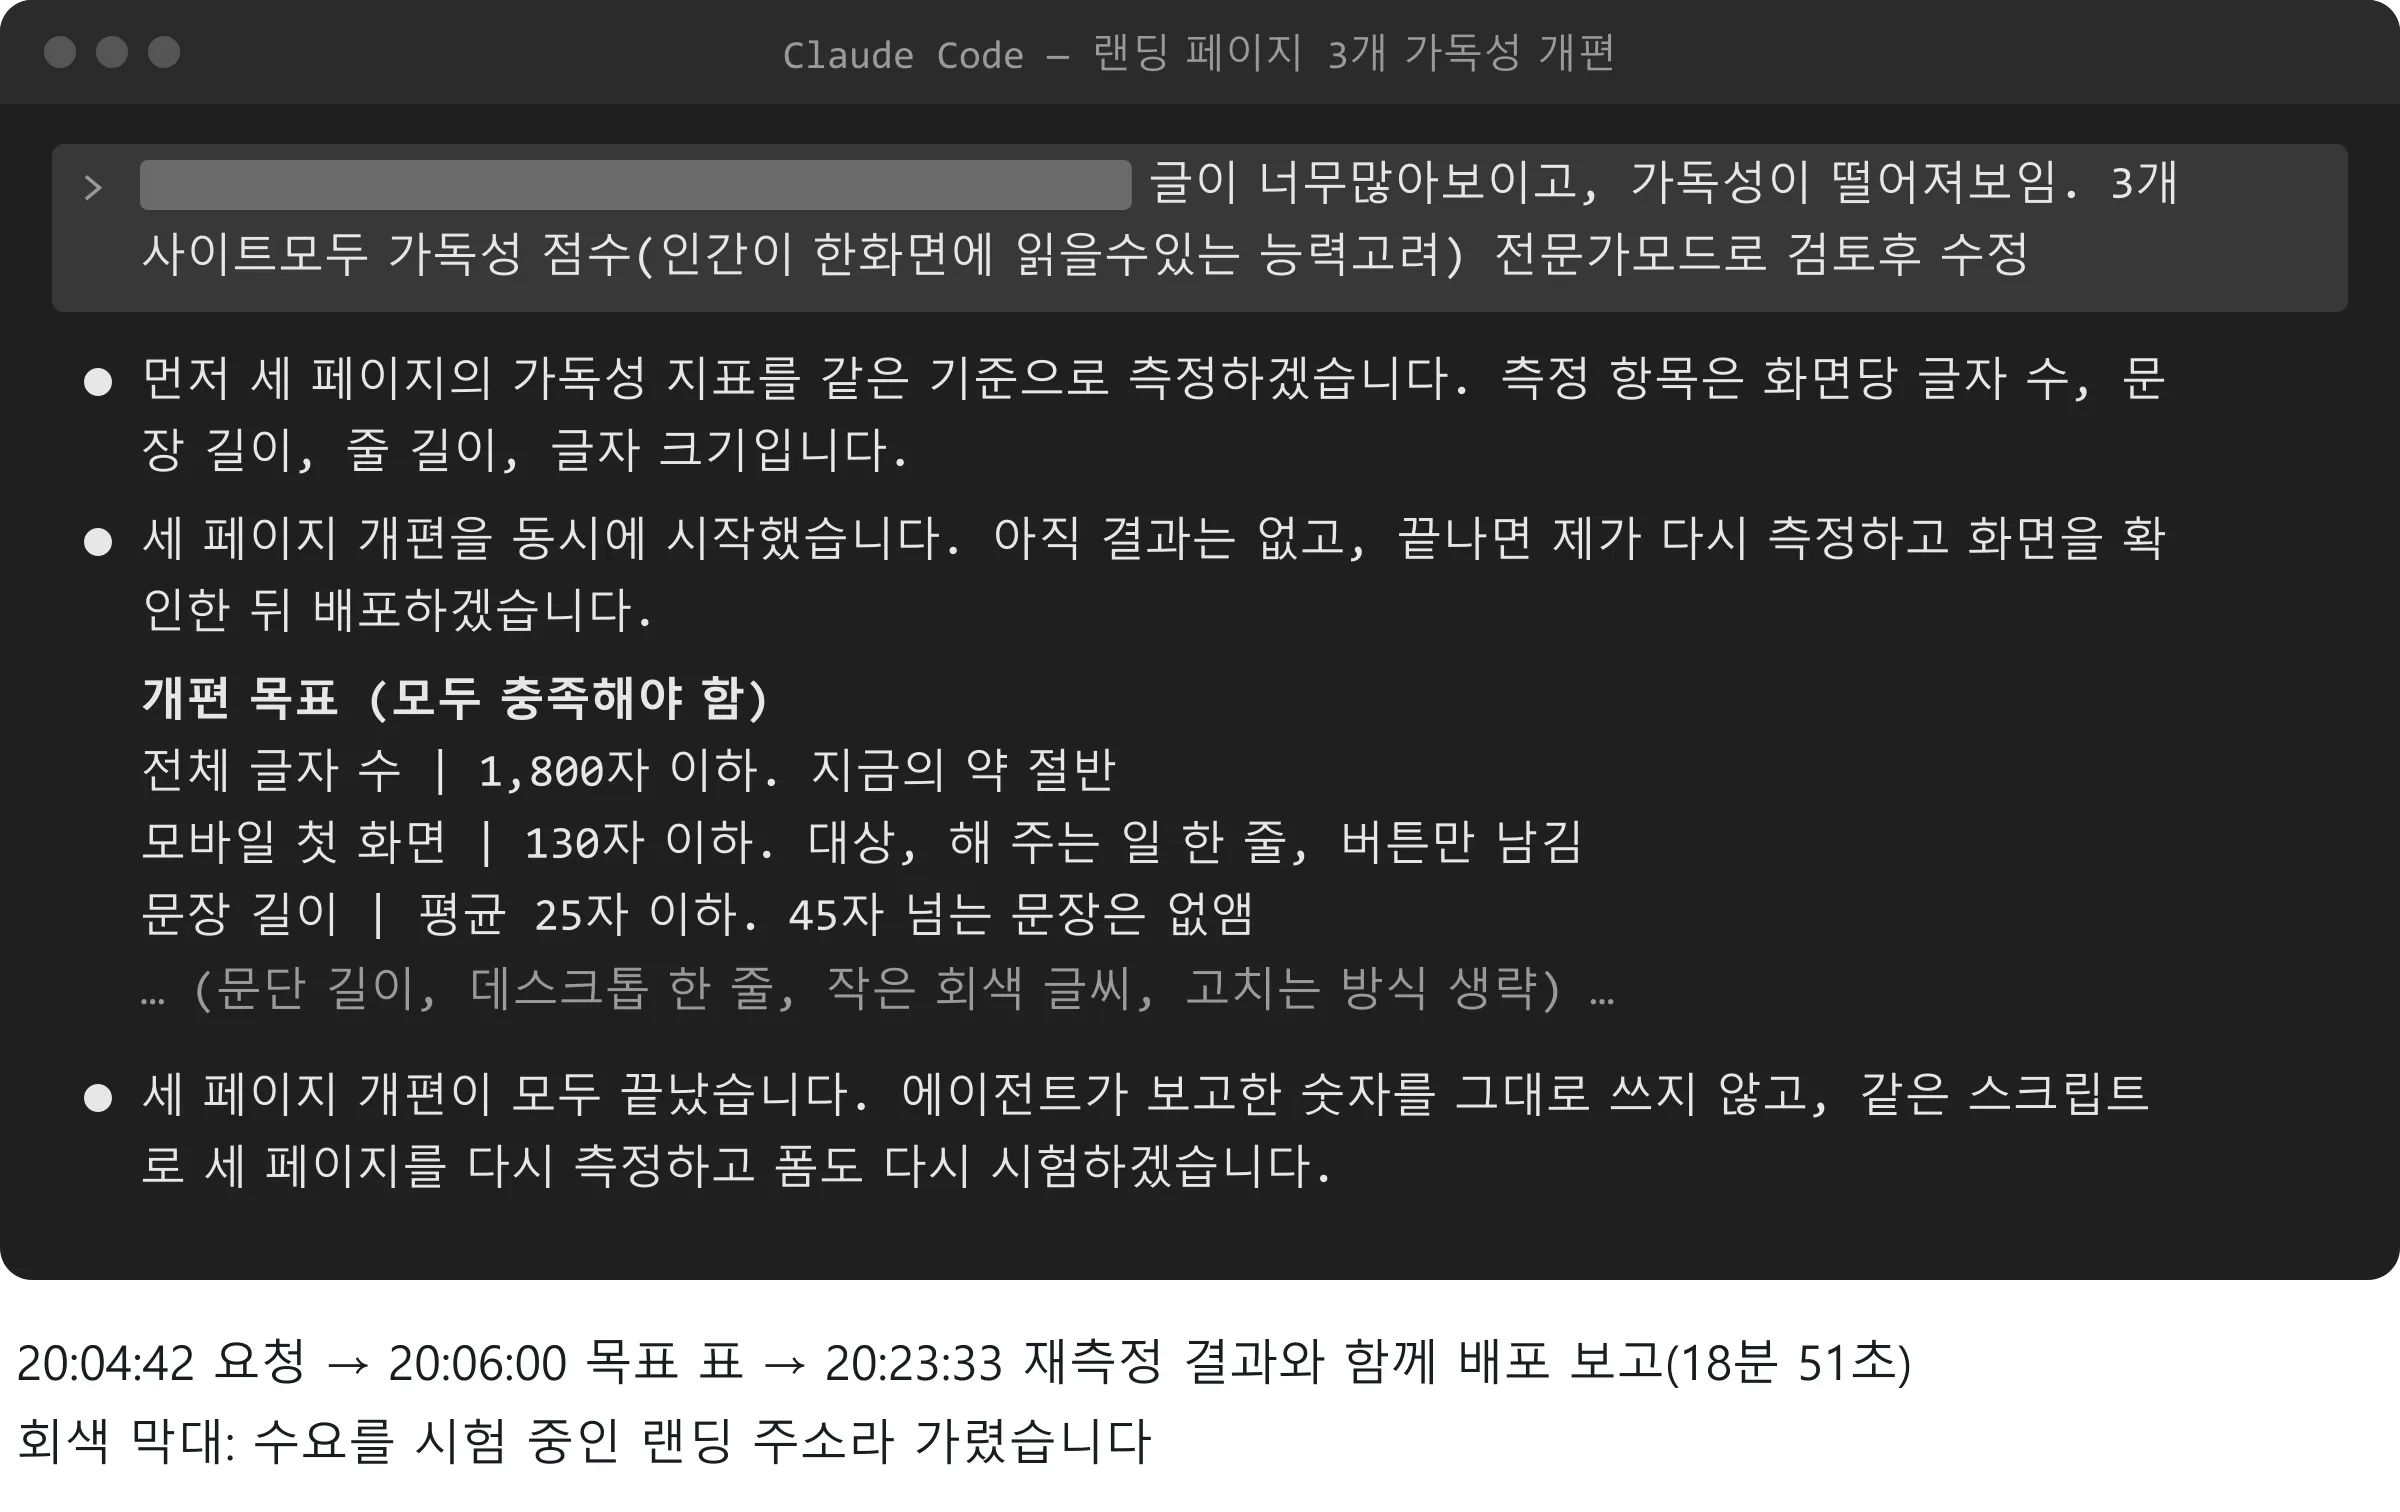
눈여겨볼 장면이 하나 더 있습니다. 하위 작업자는 페이지 A를 1,028자로 보고했는데, AI가 “보고한 숫자를 그대로 쓰지 않고” 같은 스크립트로 다시 재서 1,016자로 보고했습니다. 숫자 기준을 주면 이렇게 서로 대조할 근거가 생깁니다.
2. 하나 말고 시안 3개를 받아 고르기
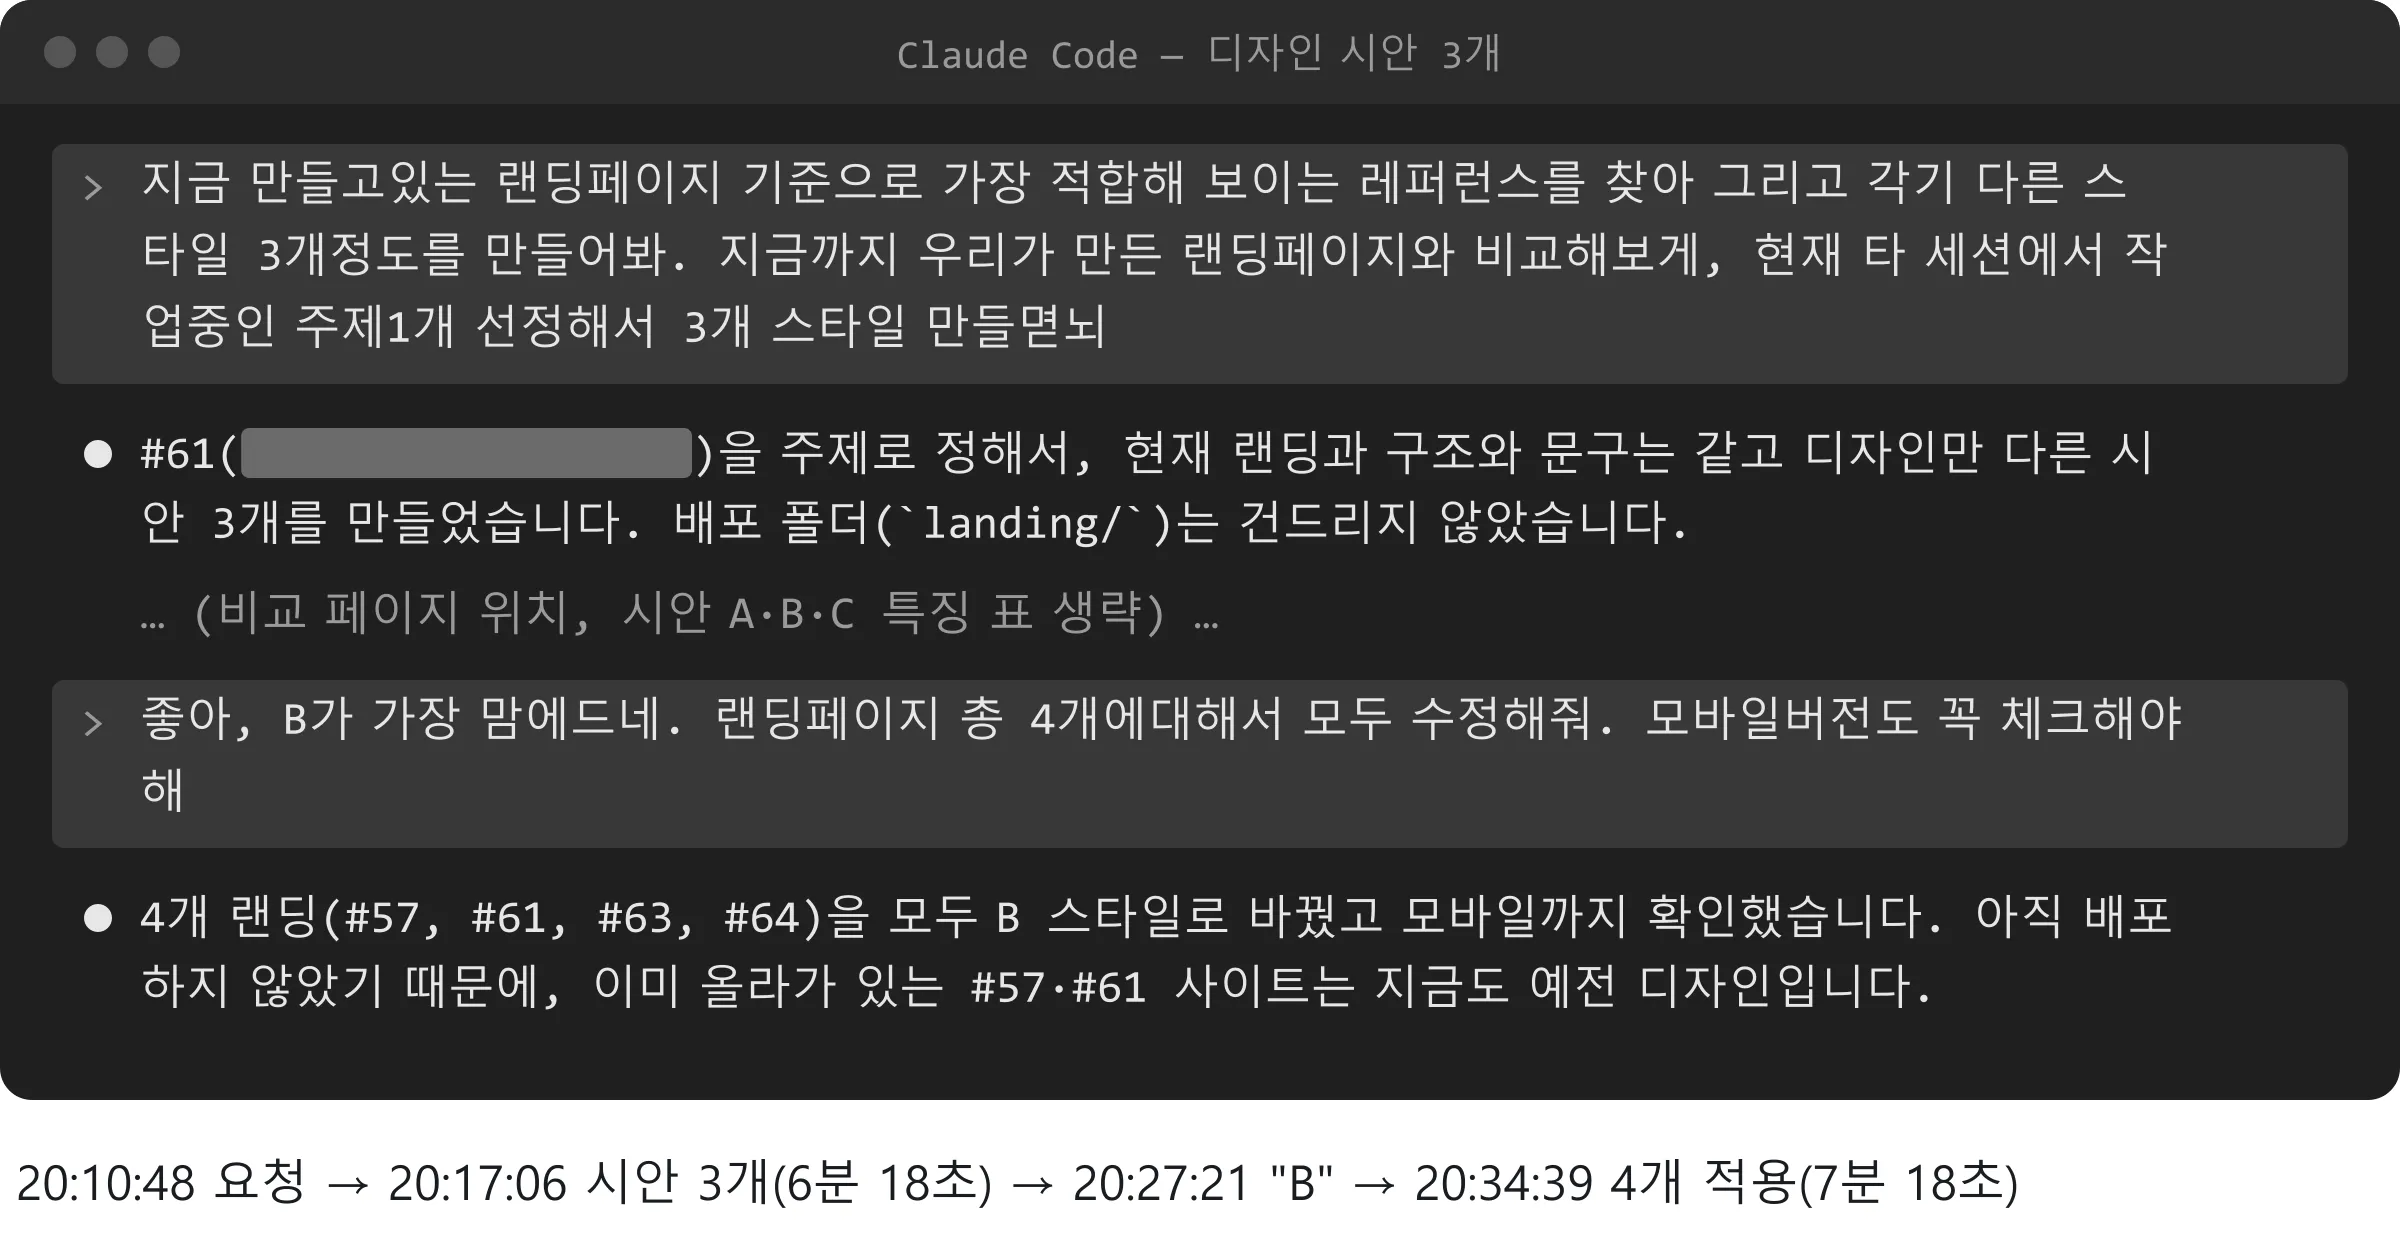
디자인 방향이 마음에 안 들 때는 고쳐 달라고 하는 대신 시안 여러 개를 받아 고를 수 있습니다. 원하는 모양을 말로 설명하지 않아도 되고, 이 기록에서 고르는 말은 “B” 한 글자였습니다.
- 요청: “각기 다른 스타일 3개정도를 만들어봐. 지금까지 우리가 만든 랜딩페이지와 비교해보게”
- 6분 18초 뒤: 내용은 같고 디자인만 다른 시안 3개, 지금 버전과 나란히 보는 비교 화면. 실제 사이트는 건드리지 않았습니다.
- “좋아, B가 가장 맘에드네. 랜딩페이지 총 4개에대해서 모두 수정해줘. 모바일버전도 꼭 체크해야해” → 7분 18초 뒤 4개 적용
3. 기준이 되는 예 하나와 이유를 같이 말하기
“더 예쁘게” 대신 누구나 떠올릴 수 있는 예 하나를 대고, 왜 중요한지 한 줄을 붙입니다. 출퇴근·급여 업무 앱 데모에서 보낸 말은 이랬습니다.
“아 데모라지만 사용자는 디자인만봐도 프로그램의 수준을 판단하기쉬운법인데, 디자인을 너가 가능한 역량 최대한으로 활용해서 작업해 (토스 스타일)”
- 23분 19초 뒤 화면 전체 리디자인이 끝났습니다. 그사이 AI는 화면을 직접 띄워 잘리는 글자와 간격을 스스로 고쳤습니다.
- 이후 같은 대화에서 디자인을 다시 요청한 메시지는 없었습니다.
- Claude Code 공식 모범 사례도 AI가 요청을 작게 읽는 편이라, 더 큰 결과를 원하면 어디까지 만들지 직접 말하라고 안내합니다.
4. 누가 읽는지 말하기
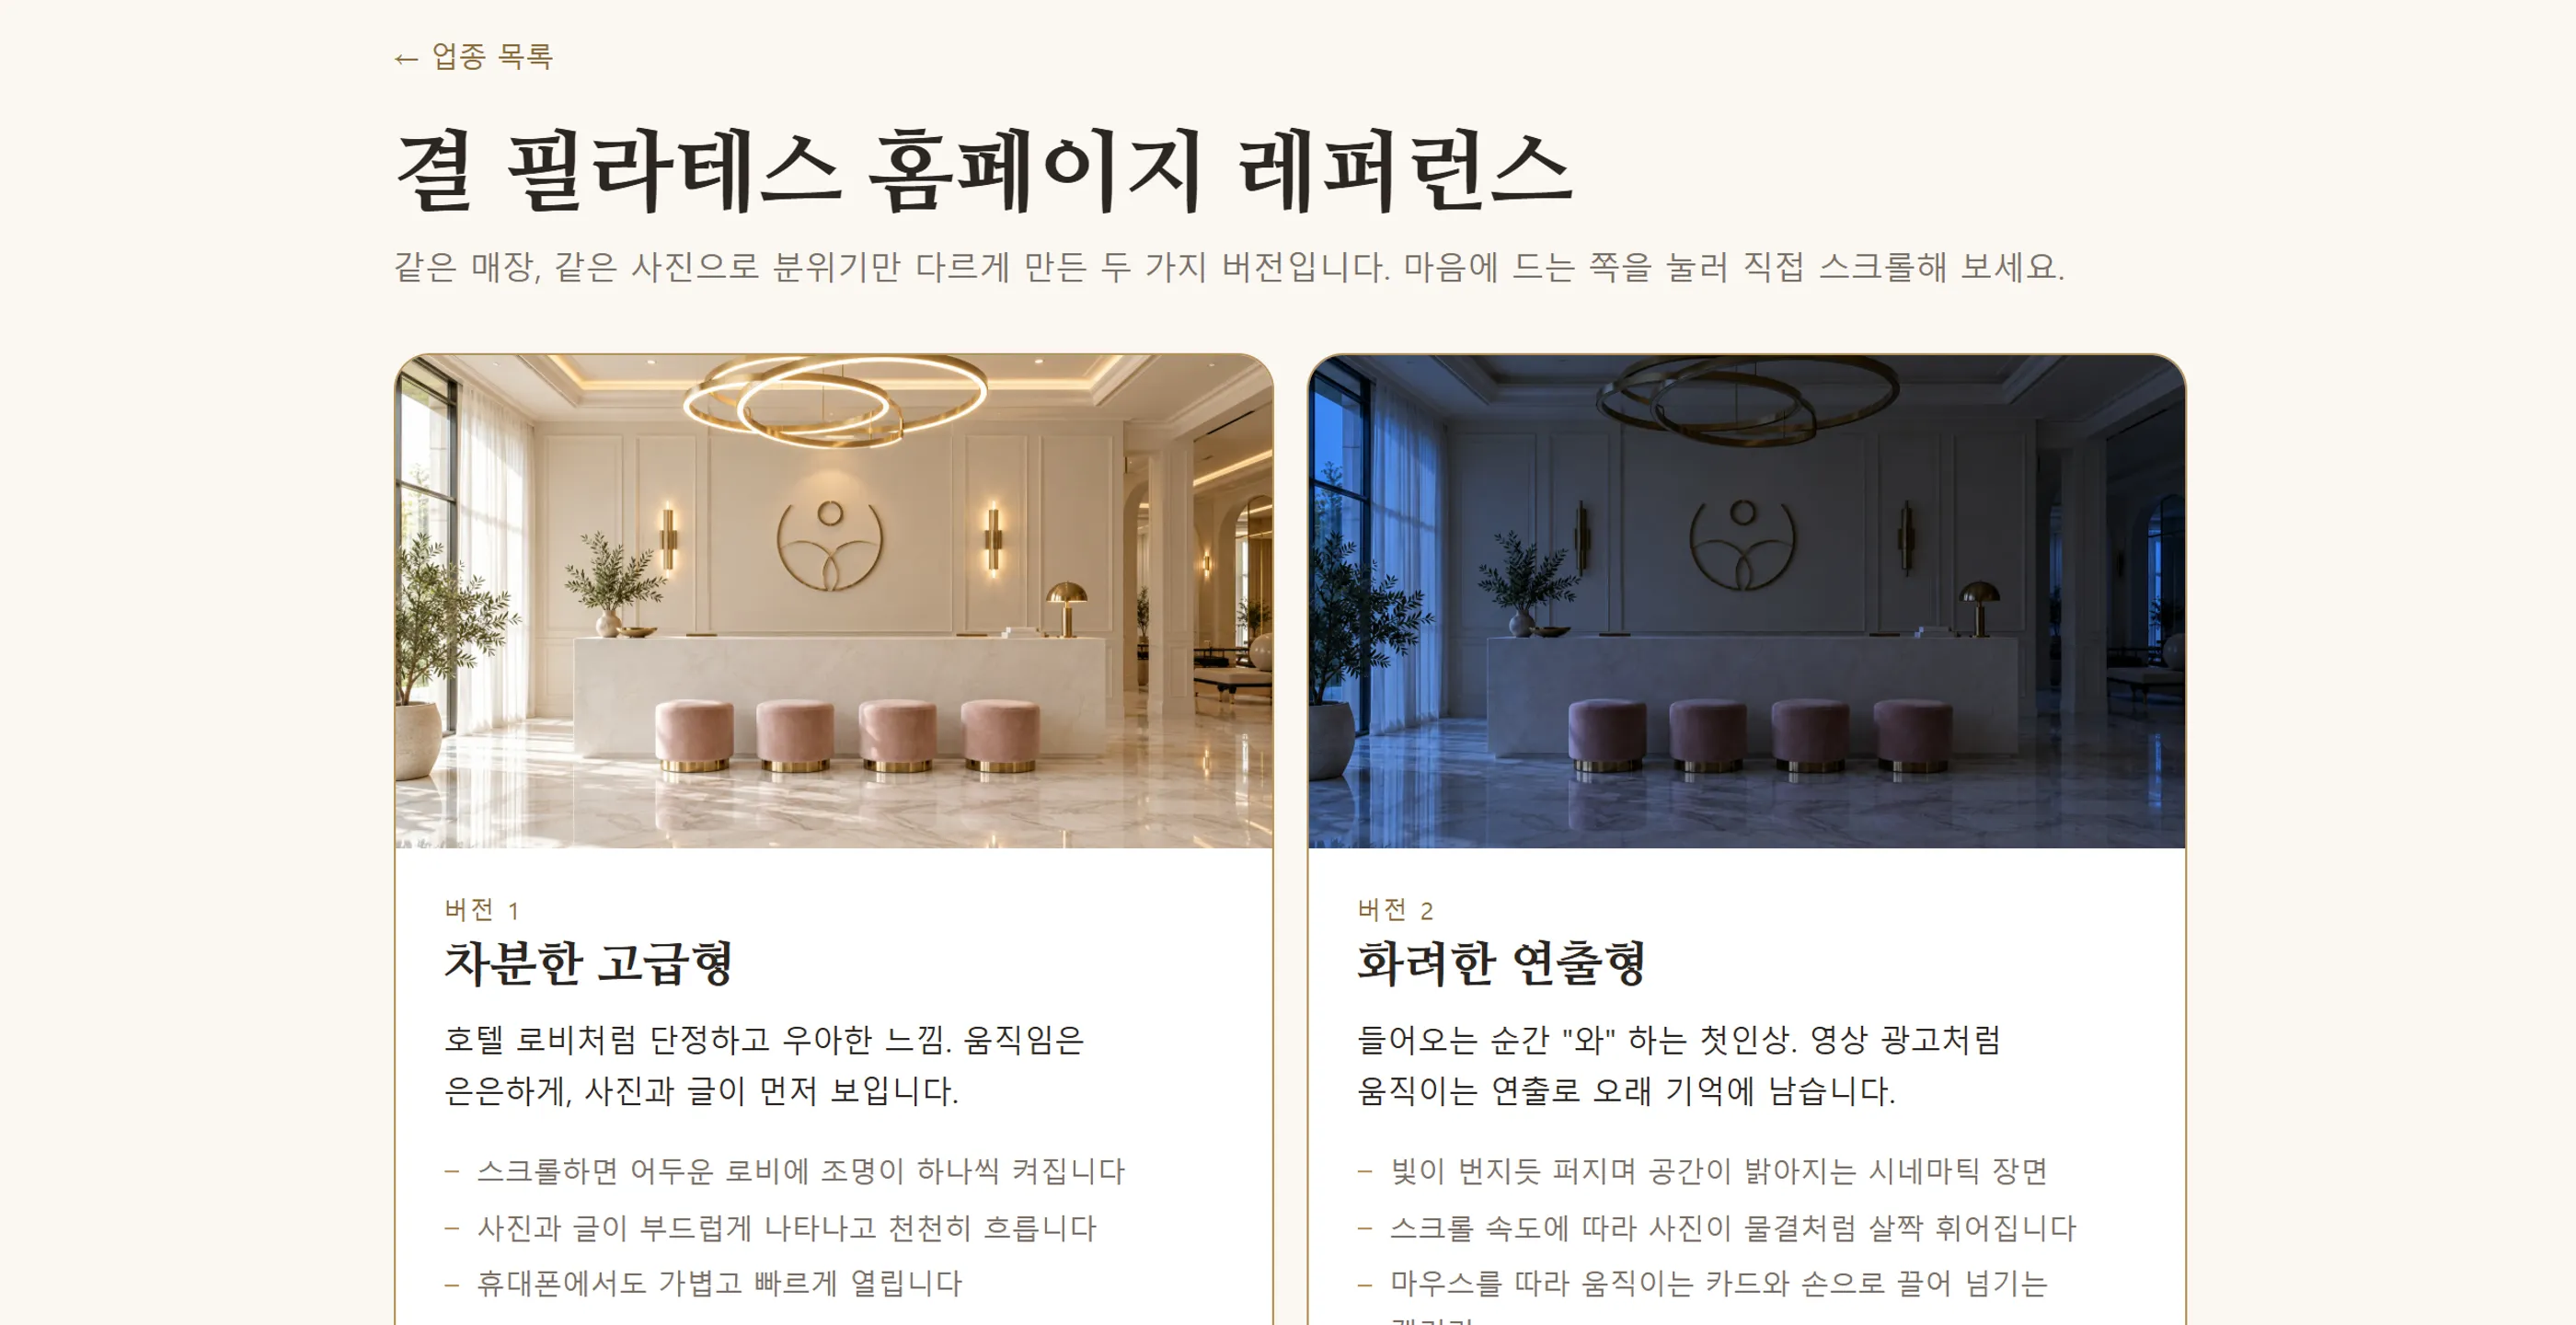
결과물이 만든 사람 말투로 나왔다면 “누가 읽는지”만 바꿔 말해도 됩니다. 필라테스 샘플 페이지의 버전 선택 화면에 “너무 기술적인 내용으로 보임. 사용자 관점에서 두가지버전 이해 쉽도록(일반인) 수정”이라고 보냈습니다.
- 3분 5초 뒤 배포까지 끝났습니다.
- 버전 이름 “v1 · Refined / v2 · Showcase”가 “차분한 고급형 / 화려한 연출형”으로 바뀌었고, 카드마다 대표 사진과 분위기 설명 한 줄이 붙었습니다.
5. “예시일 뿐”이라고 말하고, 어색한 줄은 그대로 붙여 넣기
참고 글을 주면 AI가 거의 그대로 따라 쓸 때가 있습니다. 이때는 “예시일 뿐”이라고 분명히 말하고, 고칠 때는 어색한 문장을 그대로 복사해 붙여 넣습니다. 어디를 말하는지 AI가 추측할 필요가 없습니다.
| 시각 | 사람이 보낸 말 | 그 뒤 AI가 쓴 본문 글자 수 |
|---|---|---|
| 09:22:40 | (AI의 첫 글) | 357자 |
| 09:23:09 | “post 너무 똑같잖아, 예시일뿐이고 니가 다시 작성해.. 창의적으로” | 353자 |
| 09:24:29 | 어색한 세 줄을 그대로 붙여 넣고 “이런문구는 좀 어색하고 없는게 나을듯” | 266자 |
| 09:25:25 | “1. 아니 굳이 안넣어도되. … 2. 이것도 실제 컨택할때 설명할거야” | 237자 |
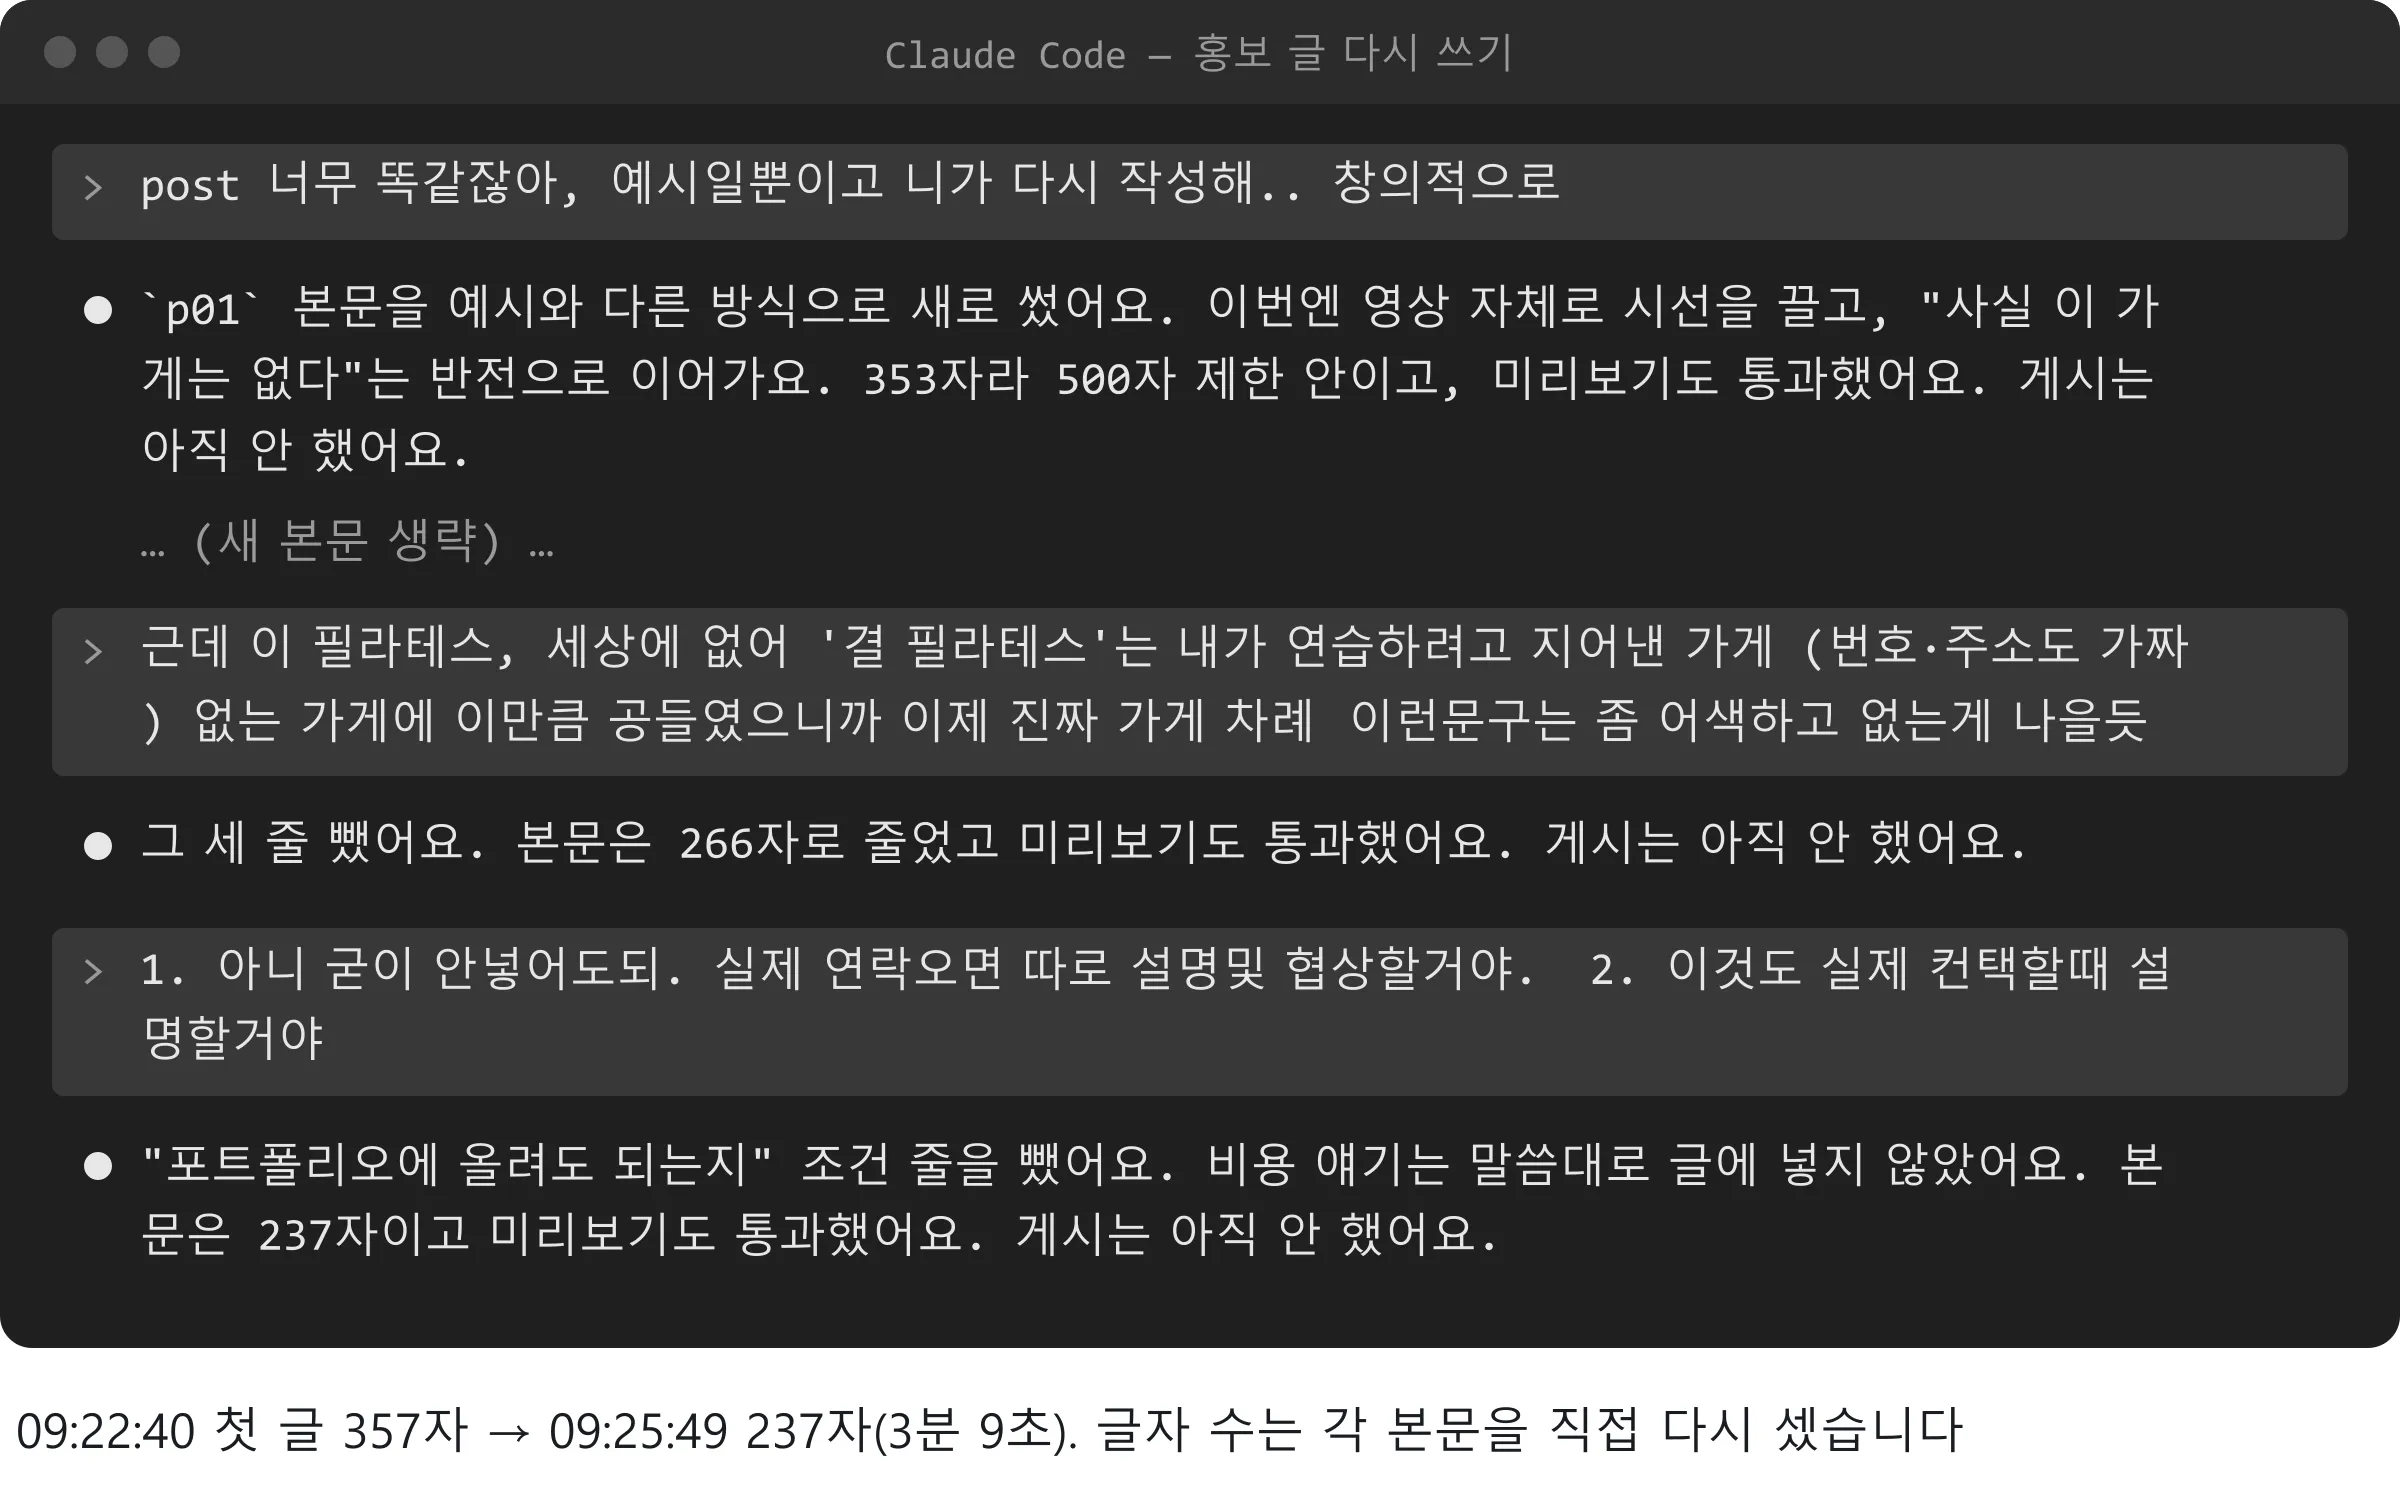
글자 수는 각 버전 본문을 제가 직접 다시 셌고(줄바꿈 포함), AI가 보고한 숫자와 같았습니다.
6. 말로 안 되면 그려서 보내기
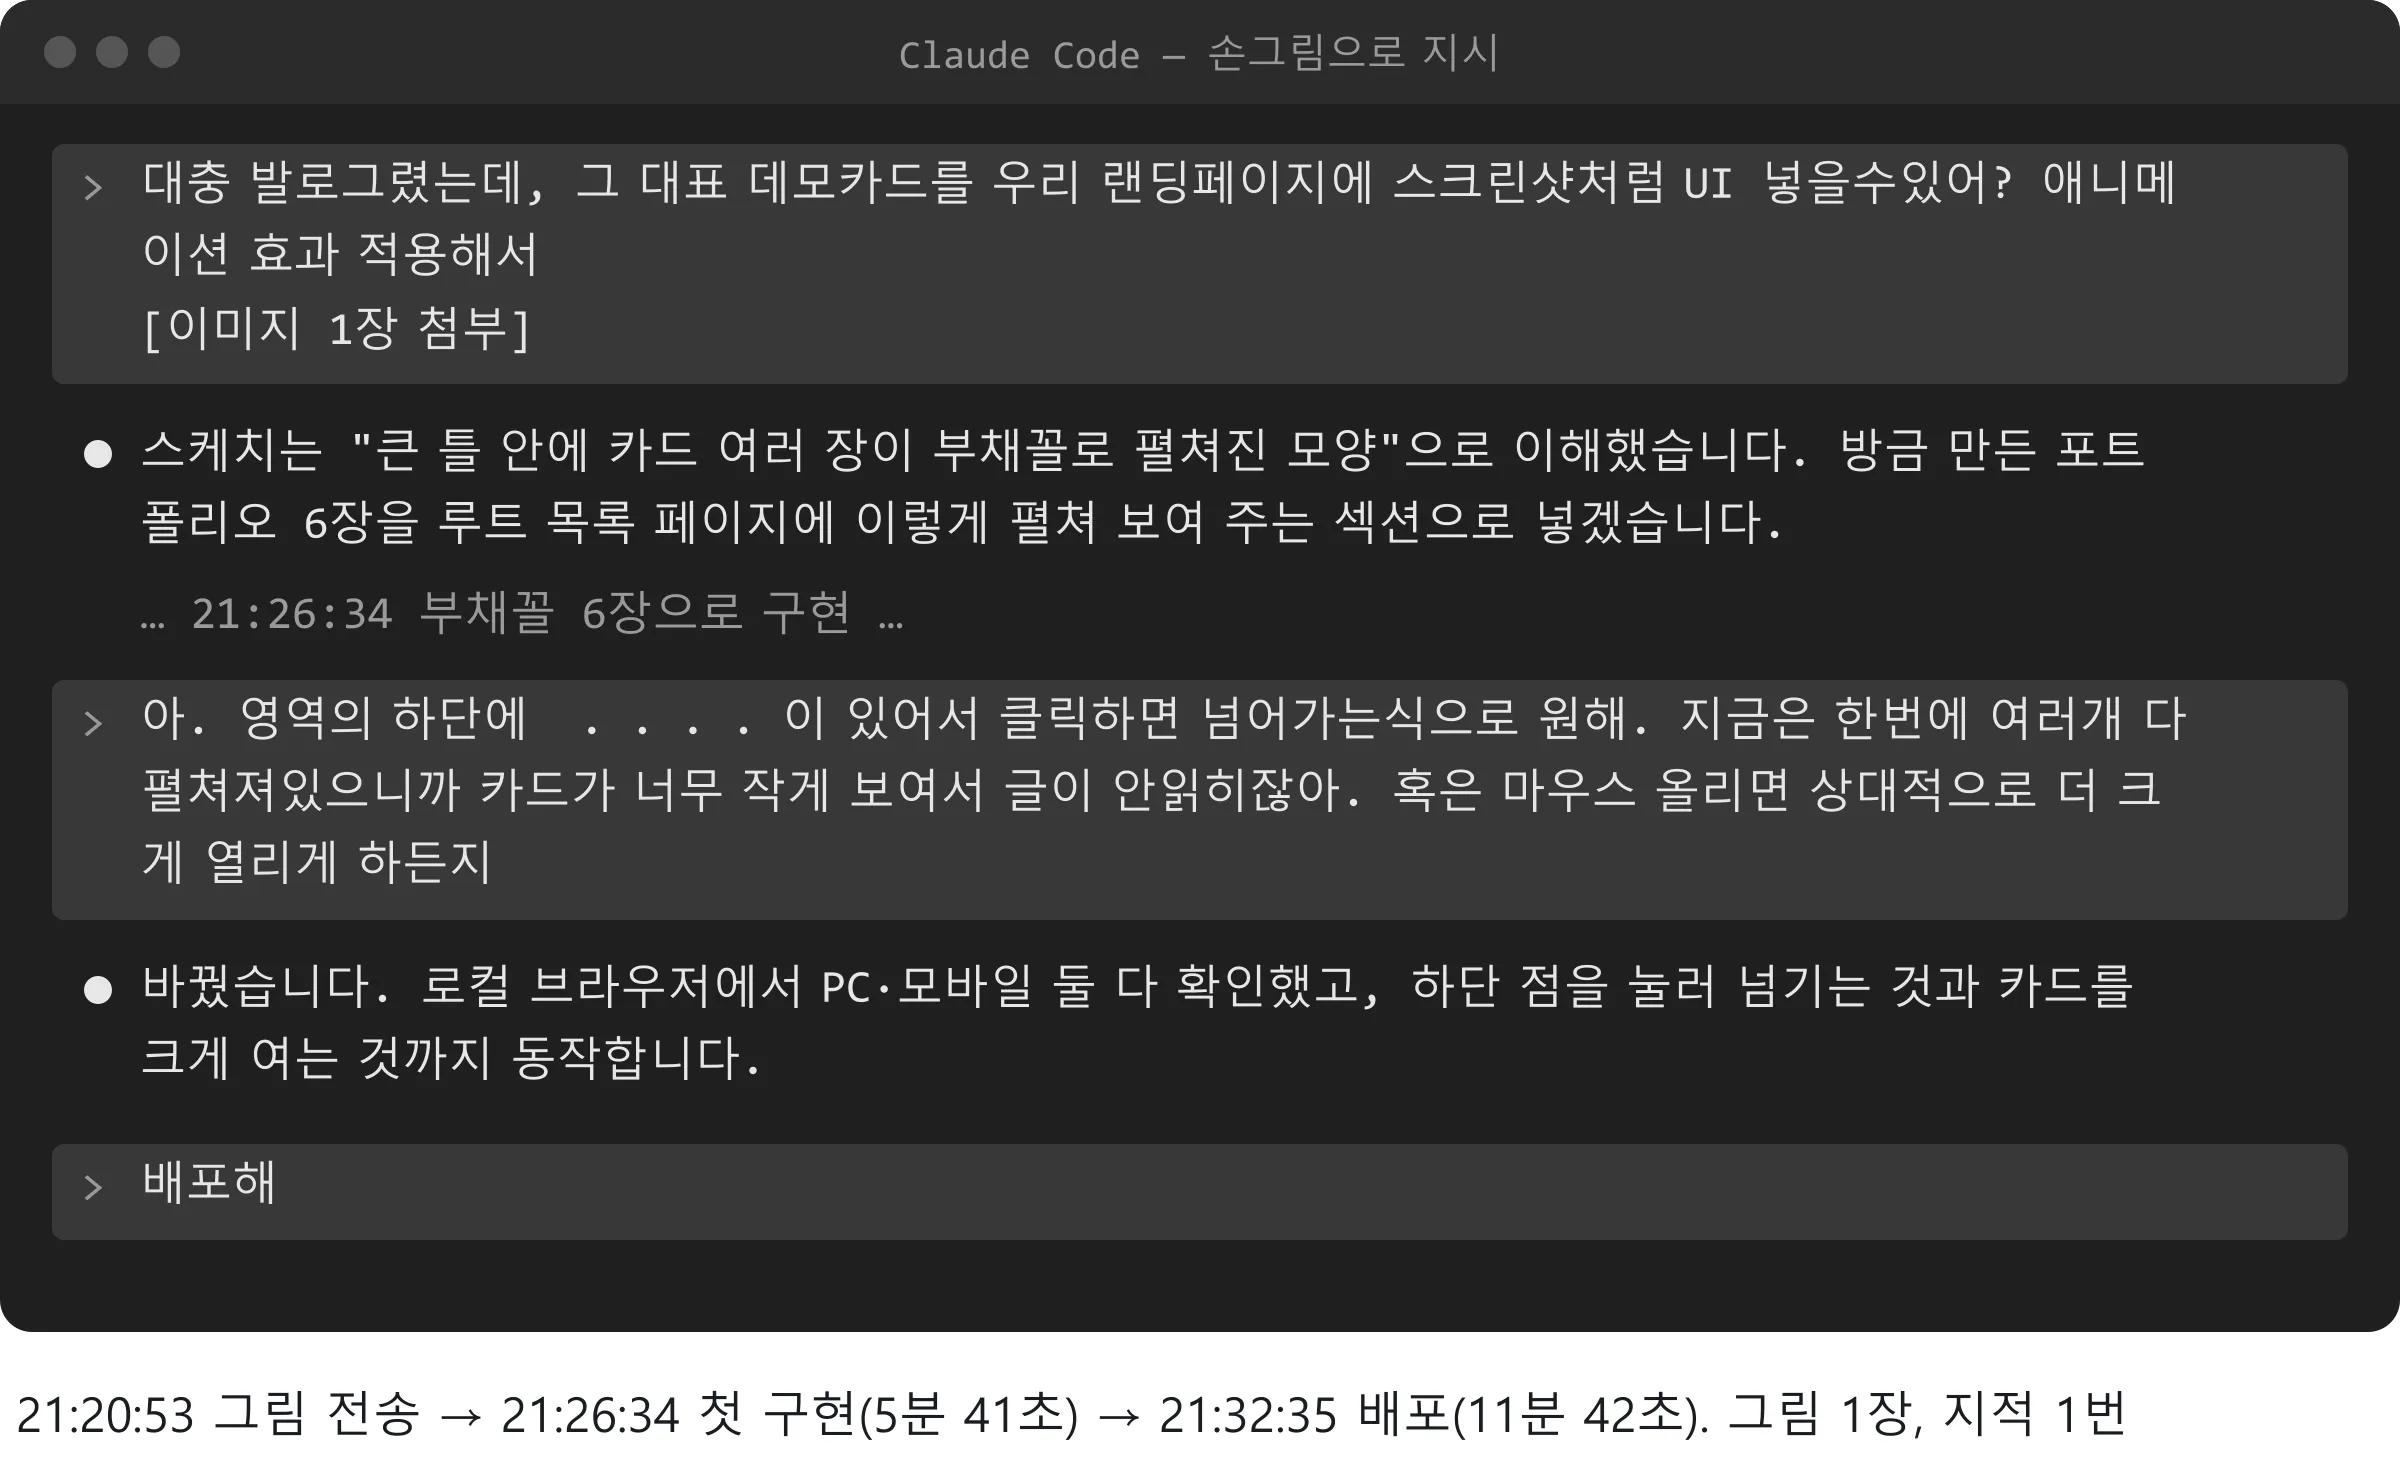
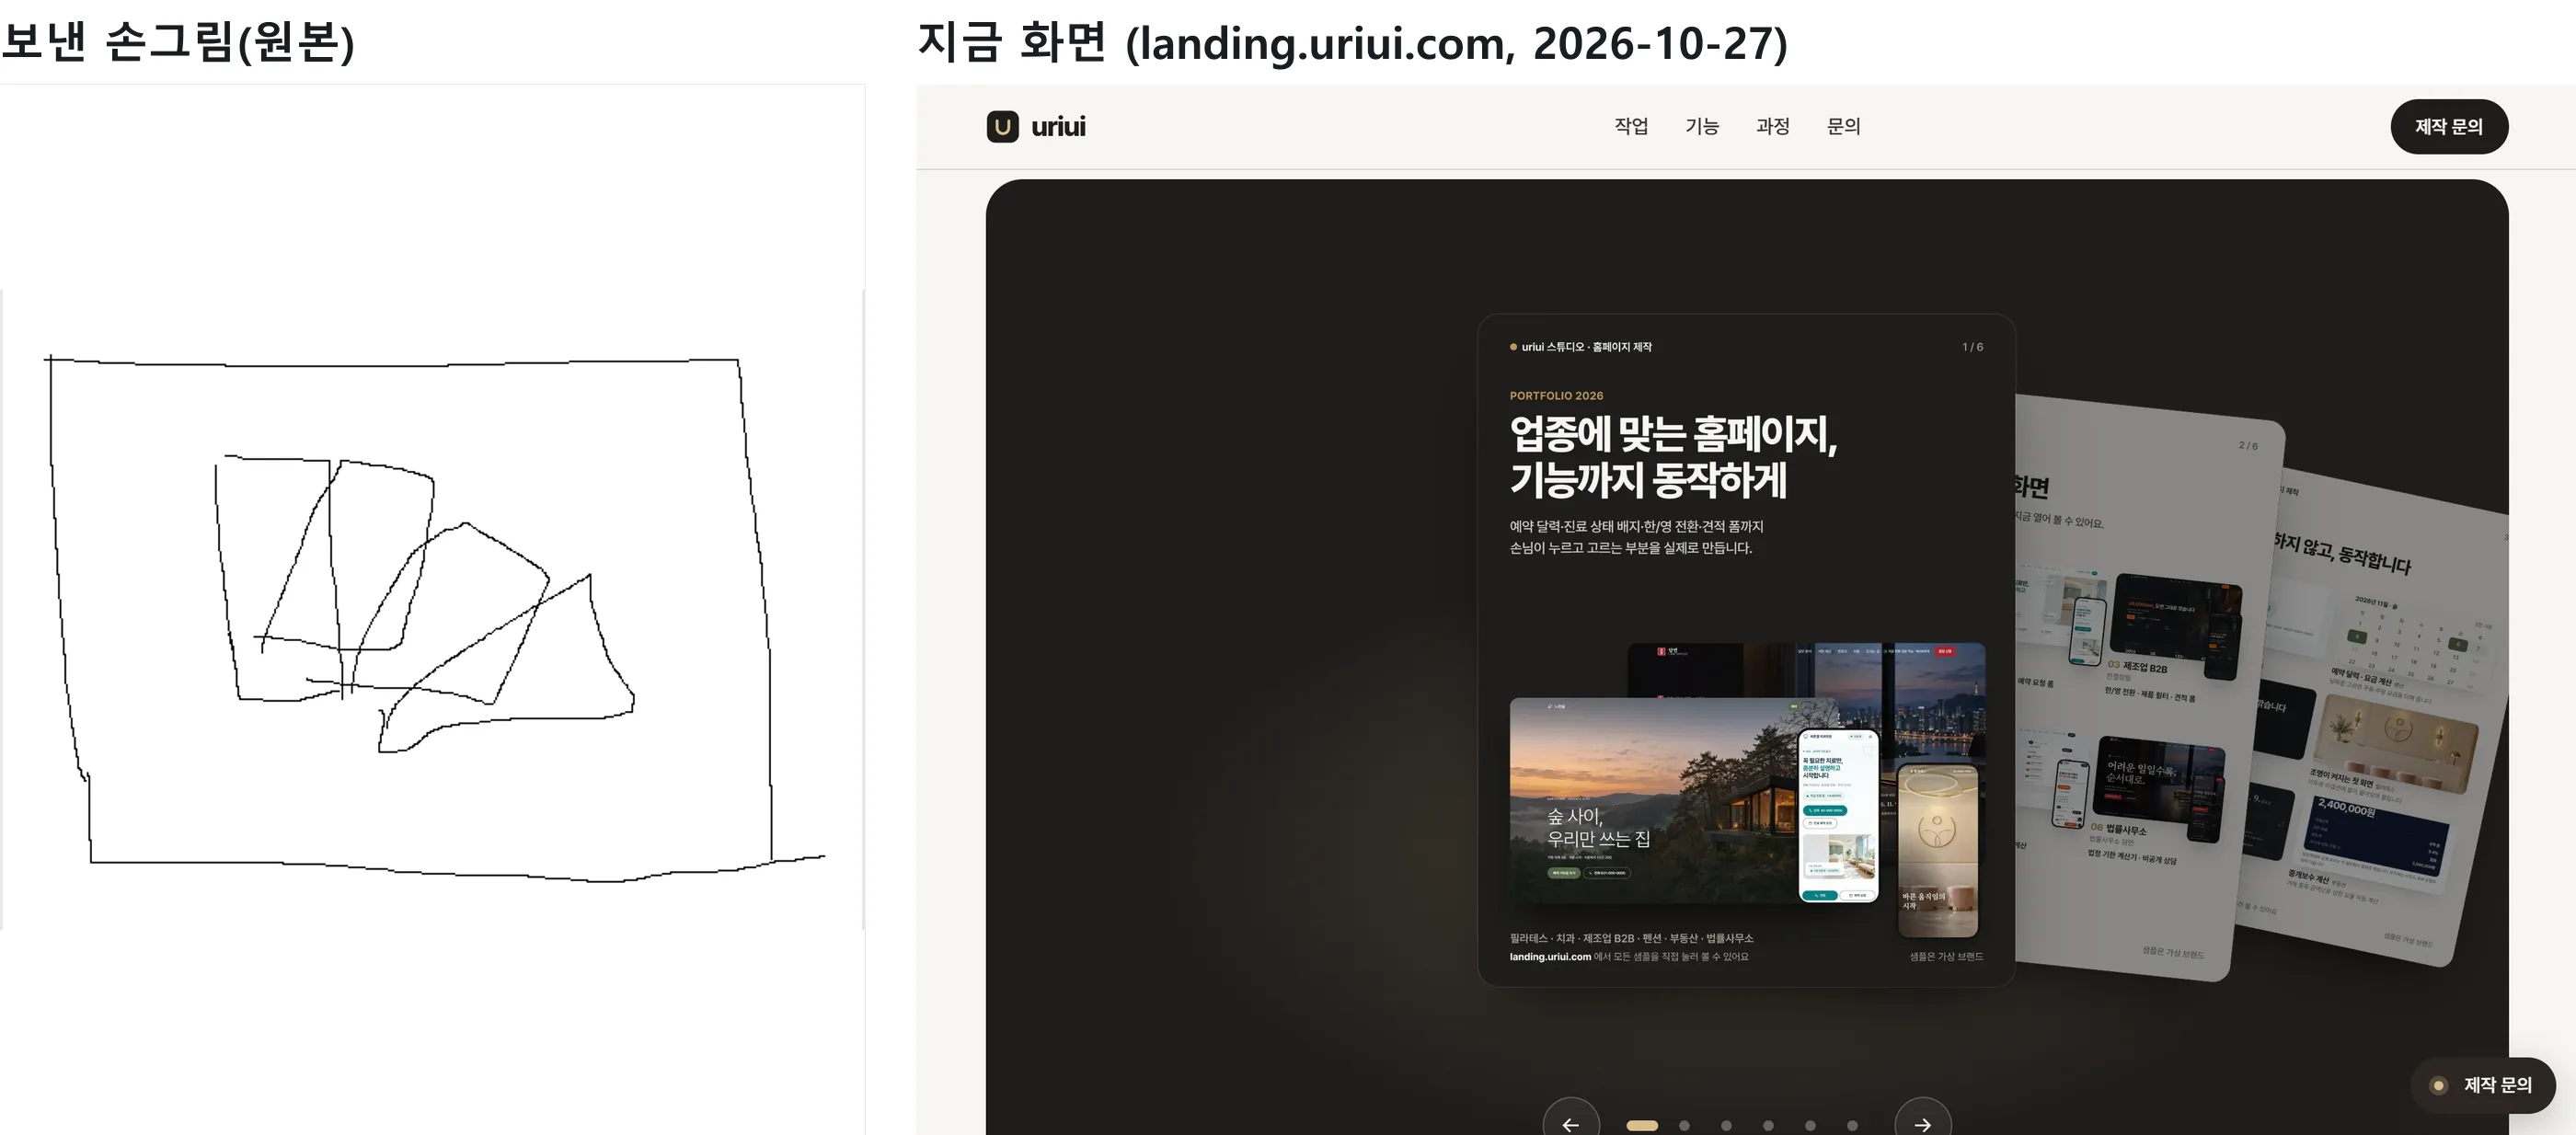
배치나 움직임은 말보다 그림이 빠릅니다. 그림판에 대충 그린 손그림 한 장을 보내며 “대충 발로그렸는데, 그 대표 데모카드를 우리 랜딩페이지에 스크린샷처럼 UI 넣을수있어? 애니메이션 효과 적용해서”라고 했습니다.
- AI가 그림을 “큰 틀 안에 카드 여러 장이 부채꼴로 펼쳐진 모양”으로 이해했다고 먼저 말했습니다.
- 5분 41초 뒤 부채꼴 6장으로 구현했는데, 한꺼번에 펼쳐져 카드 글씨가 안 읽혔습니다.
- “영역의 하단에 . . . . 이 있어서 클릭하면 넘어가는식으로 원해. 지금은 … 카드가 너무 작게 보여서 글이 안읽히잖아”라고 이유를 붙여 한 번 짚었습니다.
- 가운데 한 장을 크게 보여 주고 아래 점으로 넘기는 방식으로 바뀌었고, “배포해”까지 11분 42초였습니다.
직접 해본 결과
6가지 기록을 한 줄씩 정리하면 이렇습니다.
- 짧게 끝난 기록은 읽는 사람을 바꿔 말한 경우(3분 5초)와 어색한 줄을 그대로 붙여 넣은 경우(3분 9초, 메시지 3개)였습니다. 다만 작업 크기가 서로 달라 시간끼리 비교할 수는 없습니다.
- 디자인 방향은 시안 3개 고르기가 고르는 말 한 글자로 끝났습니다.
- 1·3·4·5번에는 “무엇이 문제인지”와 “무엇을 기준으로”가 한 문장에 함께 들어 있었습니다. 2번(시안)과 6번(그림)은 기준을 말 대신 시안과 그림으로 줬습니다.
- 공식 모범 사례도 같은 방향입니다. “고쳐졌다”의 모습을 미리 말하면 수정 한 번을 아낄 수 있고, 디자인은 화면 이미지를 붙여 넣으라고 안내합니다.
주의할 점과 한계
- 비교 실험이 아닙니다. 말버릇마다 실제로 한 번 있었던 기록이고, 같은 일을 “별로야”로 시켜 본 기록은 없습니다. 이 말버릇이 시간을 몇 분 줄인다고는 말할 수 없습니다.
- 가독성 수치는 AI가 잰 값입니다. 고치기 전 파일이 남아 있지 않아 제가 다시 재지 못했습니다. 대신 AI가 하위 작업자 보고를 다시 재 바로잡은 기록은 확인했습니다.
- “재요청 없음”은 그 대화 안에서만입니다. 다른 날 다른 대화에서 같은 화면을 다시 고쳤을 수 있습니다.
- 결과 확인은 사람 몫입니다. AI가 “다 됐다”고 하면 측정 결과나 화면 캡처를 같이 보여 달라고 하세요. 이 글의 사례들도 마지막은 사람이 화면을 보고 “배포해”라고 했습니다.
- 가린 부분이 있습니다. 수요를 시험 중인 랜딩 페이지의 주소와 주제는 실험에 영향을 주지 않도록 가리고 A·B·C로 불렀습니다.
자주 묻는 질문
AI에게 하는 좋은 요청과 나쁜 요청은 무엇이 다른가요?
이 글의 기록에서 바로 고쳐진 요청은 무엇이 문제인지와 함께 기준(숫자, 읽는 사람, 참고할 예)을 말한 경우였습니다.
디자인이 마음에 안 들면 어떻게 말해야 하나요?
방향 자체가 마음에 안 들면 내용은 그대로 두고 스타일만 다른 시안 3개를 요청해 골라 보세요. 이 글의 사례에서는 시안 3개가 6분 18초 만에 나왔고, 하나를 고르자 페이지 4개에 7분 18초 만에 적용됐습니다.
코딩을 몰라도 이런 지시를 할 수 있나요?
여섯 가지 모두 화면과 문장을 보고 하는 말이라 코드를 읽을 필요가 없습니다. 다만 AI가 "다 됐다"고 하면 측정 결과나 화면 캡처 같은 증거를 함께 보여 달라고 하세요.
근거와 출처
직접 해 본 근거
- 직접 측정 2026년 10월 23~26일에 Claude Code로 진행한 프로젝트 3개의 대화 기록에서 지시를 보낸 시각과 결과가 나온 시각을 직접 뽑아 걸린 시간을 쟀습니다. 홍보 글 글자 수는 각 버전 본문을 직접 다시 셌습니다. 가독성 수치는 AI가 측정 스크립트로 잰 값이며 대화 기록에 남은 그대로 옮겼습니다.
- 직접 캡처 결과 화면 2장(손그림을 보고 만든 소개 카드, 일반인 관점으로 고친 선택 화면)은 2026년 10월 27일에 공개 페이지를 직접 캡처했습니다. 대화 장면 4장은 기록 원문을 Claude Code 화면 형태로 다시 그린 것이며 직접 캡처한 화면이 아닙니다.
- 결과 파일 6가지 말버릇을 상황별 빈칸 문장으로 정리한 텍스트 파일을 내려받을 수 있습니다.